Un modèle pour les tâches longues, pas un travail terminé à lui seul
Le modèle produit un raisonnement et des propositions ; le système qui l’entoure organise les actions, les outils et leur contrôle.
La page DeepMind présente Argon pour le développement logiciel, les travaux de connaissance en entreprise et la cyberdéfense. Ces familles d’usage partagent une difficulté : la bonne réponse dépend d’une suite d’opérations, pas d’une seule formulation. Notre lecture est que l’intérêt doit donc se juger sur le parcours complet, et non sur la seule élégance du résultat final.
Prenons une modification de logiciel. Lire la demande, comprendre les dépendances, proposer une solution et contrôler ses effets sont des responsabilités différentes. Une proposition convaincante peut rester incomplète si elle ignore une contrainte. Un agent doit pouvoir observer ce qui s’est réellement passé, comparer cette observation à l’objectif et demander une décision lorsque le périmètre devient ambigu.
Il faut distinguer compétence et autorisation. Savoir proposer une action n’implique pas avoir le droit de l’exécuter. Une démonstration devrait préciser résultat attendu, environnement autorisé, critères d’arrêt et responsable de validation.
Qui peut réellement utiliser Argon au 2 octobre 2026 ?
Une annonce, un déploiement limité et un service ouvert sont trois états différents.
L’annonce anglaise prévoit un élargissement aux développeurs, entreprises et consommateurs, en commençant par les clients API payants et Google AI Ultra. Les catalogues API et Enterprise consultés ne listent pourtant aucun endpoint Argon. Une traduction officielle est plus affirmative sur le déploiement : cette divergence ne permet pas de confirmer un accès général, notamment en France.
L’absence dans un catalogue n’établit pas qu’aucun partenaire ne l’utilise. Elle empêche en revanche de fournir honnêtement un identifiant public, un quota ou une procédure d’activation universelle. Nous ne proposons donc pas un tutoriel fictif fondé sur le nom du modèle. La date d’une ouverture plus large reste à confirmer.
Avant une intégration, il faut confirmer modèle autorisé, conditions, région, quotas et support pour son compte. Un accès de test n’est pas une capacité de production acquise. Le tableau résume les preuves, pas une promesse commerciale.
| Situation | Ce qui est établi | Ce qui ne l’est pas |
|---|---|---|
| Fairwind | Accès contrôlé à une cohorte de partenaires | Accès automatique après candidature |
| Développeurs / API | Élargissement annoncé ; catalogue contrôlé | Endpoint public Argon et quotas utilisables par tous |
| Google AI Ultra | Abonnement nommé dans l’annonce | Activation garantie sur un compte français |
| Entreprises | Accès encadré et offres distinctes | Disponibilité générale dans toutes les régions |
Un million de tokens : préciser ce que ce nombre mesure
L’entrée, la sortie et le raisonnement consomment des tokens, mais leurs limites et leur facturation ne sont pas interchangeables.
L’annonce originale décrit une limite de sortie portée à un million de tokens. Cela n’est pas une fiche confirmant une fenêtre d’entrée publique de même taille. Le PDF d’évaluation décrit par ailleurs des tests GraphWalks entre 256 000 et un million de tokens de contexte. Une configuration de benchmark ne devient pas automatiquement le quota d’un service commercial.
La documentation générale Gemini distingue les tokens d’entrée, de sortie, de réflexion, de cache et d’outils. Un token n’est pas un mot fixe : le découpage dépend du contenu. Pour préparer un travail, il est donc préférable de mesurer les données réellement transmises plutôt que de convertir une limite en nombre de pages par une règle approximative.
Notre analyse est qu’une grande capacité peut donner davantage de place à une exploration, sans garantir sa pertinence. Un raisonnement long peut s’éloigner de l’objectif. Il faut définir ce que l’on veut obtenir : une décision argumentée, un changement vérifiable ou une liste d’incertitudes. Une limite maximale n’est ni une durée garantie ni une obligation de l’utiliser entièrement.
Développement : raisonner, agir, puis vérifier
Une tâche d’ingénierie associe du code, un environnement et des preuves de fonctionnement.
Le guide général Gemini sur les appels de fonctions explique qu’un modèle peut demander une opération définie par l’application, qui lui retourne ensuite le résultat. C’est une mécanique d’outillage, pas une preuve que chaque outil serait déjà exposé publiquement avec Argon. Le nom d’un modèle ne suffit pas à définir les permissions du système qui l’utilise.
Dans notre méthode de travail, une migration commence par une référence stable : comportement attendu, tests disponibles et limites de la modification. Le résultat doit ensuite être relu à ces mêmes conditions. Une compilation réussie n’établit pas à elle seule l’équivalence du comportement ; une modification correcte sur un exemple peut manquer un autre chemin d’exécution.
L’équipe devrait conserver une trace de l’investigation : fichiers concernés, hypothèses rejetées, contrôles et points non résolus. C’est ce qui distingue une aide vérifiable d’une délégation aveugle.
Finance et juridique : une chaîne de preuves avant une conclusion
Dans un travail de connaissance, la valeur tient aussi à la possibilité de retrouver et de discuter les pièces utilisées.
Le document d’évaluation Google inclut des benchmarks financiers et juridiques. Ils décrivent des tâches définies, pas une certification de compétence professionnelle. Leur présence ne permet pas de conclure qu’un modèle peut conseiller sans contrôle sur une situation réelle, un territoire ou un cadre réglementaire qui n’a pas été évalué.
Notre analyse consiste à séparer collecte, interprétation et décision. Une synthèse devrait rendre visibles les documents retenus, leur date, les informations manquantes et les contradictions. Un texte fluide ne remplace pas cette traçabilité. Lorsqu’une pièce est ambiguë, la sortie utile peut être une demande de précision plutôt qu’une réponse plus longue.
Nous recommandons un livrable intermédiaire : preuves, hypothèses et références consultables. Le responsable métier garde la décision. Le critère n’est pas seulement le temps gagné, mais la possibilité de comprendre et contrôler le résultat.
Lire les scores sans fabriquer un gagnant universel
Les chiffres publiés par Google correspondent à des tâches et à des protocoles, pas à toutes les demandes d’une entreprise.
Le tableau officiel annonce 77,9 % sur DeepSWE v1.1, mais 55 % sur FrontierSWE v2, contre 65,5 % pour GPT-6 Astra sur cette seconde mesure. Cette différence suffit à écarter un classement uniforme. Une sélection de scores favorables masquerait précisément les variations qui intéressent un utilisateur.
La méthodologie indique généralement pass@1 et le niveau de réflexion maximal, avec des exceptions précisées. Certains résultats sont calculés par Google ; d’autres viennent de tableaux publics ou des déclarations des fournisseurs. Le test cyber interne de découverte mesure le rappel de vulnérabilités historiques confirmées, avec accès au code. Il ne prouve pas une découverte nouvelle et exhaustive sur toute application.
Notre lecture est de comparer d’abord les conditions : outils autorisés, durée, essais, contexte et critère de réussite. Un score peut guider le choix d’un test, mais pas remplacer ce test. Pour son propre usage, mieux vaut un petit jeu de tâches représentatives incluant des échecs qu’une moyenne spectaculaire impossible à relier à son activité.
Fairwind : donner de l’avance aux défenseurs, sous conditions
La cyberdéfense met en jeu des capacités à double usage : une même méthode d’analyse peut protéger un système ou être détournée.
Fairwind réserve Argon à une partie de ses partenaires approuvés. Les conditions incluent authentification forte résistante au phishing, contrôle des équipes cyber internes et suivi des usages ; la redistribution de l’accès est interdite. L’annonce prévoit une version sans garde-fous cyber pour les défenseurs de confiance, pas la disparition de toutes les protections du modèle.
Google Cloud présente CodeMender comme un agent distinct, avec son environnement d’exécution et ses outils. Les corrections proposées restent soumises à la revue et à l’approbation du développeur avant leur intégration au dépôt. Avoir accès à CodeMender ne signifie donc pas obtenir automatiquement Argon, ni devoir accepter chaque modification sans la vérifier.
Pour nous, le point important est la relation entre capacité et droit d’agir. Autoriser une analyse sur un système ne donne pas une permission générale sur les autres. Un périmètre écrit, des comptes adaptés et un responsable de suivi restent des éléments à préparer avant toute opération. Il ne faut pas confondre autonomie technique et consentement de l’organisation concernée.
Pourquoi la sécurité ne peut pas rester dans la réponse du modèle
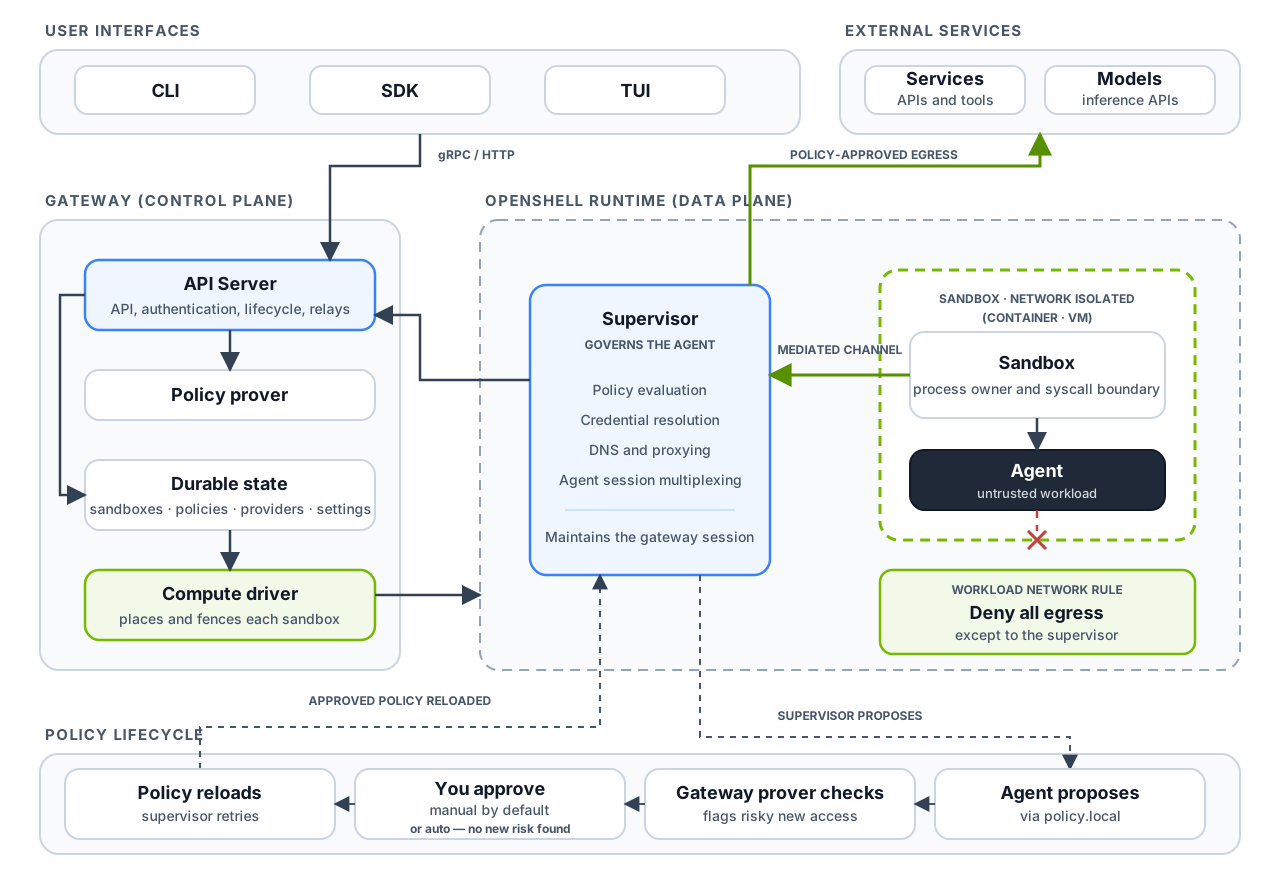
Le contrôle doit porter sur les demandes, les sources rencontrées, les actions proposées et l’environnement d’exécution.
La page Argon décrit quatre familles de protections : prévention des usages nuisibles, résistance aux injections indirectes, surveillance des écarts d’intention et durcissement des environnements isolés. Ce sont des mesures annoncées par Google, pas une garantie que tout comportement dangereux a été éliminé.
Une injection indirecte peut se présenter dans un contenu que le système lit pour accomplir sa tâche. Notre recommandation est de traiter ce contenu comme une pièce à examiner, non comme une autorité pouvant étendre les permissions. La distinction est particulièrement importante quand une tâche combine recherche, fichiers et actions sur plusieurs outils.
Garder un contrôle extérieur à l’agent
La feuille de route Google sur le contrôle des agents décrit supervision, prévention et réponse graduées selon les capacités et les conséquences. Elle concerne un cadre de sécurité général, pas une preuve que chaque produit public applique toutes ses mesures. Notre lecture en retient une exigence simple : le système qui limite une action ne doit pas dépendre uniquement de l’accord de l’agent qui veut la réaliser.
Observer le raisonnement sans le prendre pour une garantie
L’essai du DeepMind Institute sur la transparence du raisonnement décrit son utilité et sa fragilité ; il reflète les analyses de ses auteurs, pas une promesse produit. Une trace aide à enquêter, mais ne prouve pas à elle seule que toutes les causes d’une décision y sont visibles. Nous recommandons de la confronter aux actions et aux résultats réellement observés.
Données : vérifier le service exact, pas seulement la marque
Les garanties de conservation dépendent du mode d’accès, des outils et de la configuration.
La FAQ Fairwind indique une capacité de zéro rétention pour Argon accédé directement comme modèle managé sur Gemini Enterprise. La documentation Cloud précise cependant des conditions liées aux journaux, à la surveillance des abus et aux fonctions supplémentaires. Il ne faut pas étendre une capacité conditionnelle à toute interface ou toute intégration.
Nous proposons donc de poser des questions concrètes avant de transmettre des données : quel service reçoit les pièces, quels journaux sont activés, quels outils interviennent et qui peut consulter les résultats ? La présence d’un modèle récent ne répond pas à ces questions. Une configuration différente peut demander une vérification différente, même dans le même écosystème.
Il manque aussi une fiche Argon dans l’index de model cards consulté. Le PDF de benchmarks disponible ne doit pas être renommé system card. Pour notre évaluation, cette absence constatée limite ce que nous pouvons documenter sur le modèle ; elle n’autorise ni à inventer une restriction ni à supposer qu’elle n’existe pas.
Tarifs annoncés : le token n’est pas le coût d’un travail
Un prix unitaire aide à établir un budget, sans décrire toutes les dépenses d’une mission agentique.
Tarifs annoncés par Google, par million de tokens : 2 USD en entrée / 10 en sortie, puis 4 / 20, sans date de transition dans l’annonce anglaise. La variante indonésienne donne un calendrier local, pas une garantie mondiale. Argon n’est pas listé dans la tarification API consultée.
Notre analyse du budget inclut également les tentatives, les outils, l’environnement et la revue humaine. Une tâche longue peut produire un résultat précieux ou une investigation à interrompre. Il est donc utile de convenir d’une limite de dépense, d’un livrable intermédiaire et d’une condition d’arrêt avant de laisser le système poursuivre.
Le bon indicateur serait le coût d’un résultat acceptable. Une sortie peu chère nécessitant une reprise complète peut perdre son intérêt. Le budget devrait suivre l’usage et la vérification, pas la seule nouveauté du modèle.
Que préparer avant une disponibilité plus large ?
Un pilote devrait permettre de décider, pas seulement de montrer que le modèle peut agir.
Nous commencerions par une tâche bornée, des données autorisées et une référence. Le livrable doit être compréhensible sans suivre chaque étape. On définit opérations interdites, budget, validations humaines et retour arrière.
La comparaison porterait sur justesse, erreurs, clarifications et preuves. Le temps ne serait qu’une mesure parmi d’autres : repérer une incertitude peut être préférable à finir vite en la masquant. Signaler ses limites fait partie du résultat.
Le Frontier Safety Framework Google organise l’évaluation de risques et de mesures autour de capacités critiques. Il ne remplace pas les responsabilités de l’équipe qui met un service en place. La décision utile serait donc progressive : tester, comprendre les échecs, ajuster le périmètre et seulement ensuite envisager une exploitation. Argon ne dispense pas de cette méthode.
Une grille de décision, pas une promesse d’autonomie
- Accès et conditions réellement confirmés pour le compte prévu.
- Tâche, données et outils limités à un périmètre autorisé.
- Résultat comparable à une référence et relisible par l’équipe.
- Budget, critères d’arrêt et reprise définis avant le test.
- Validation humaine conservée avant une action à conséquences.
Questions fréquentes
L’accès général n’est pas confirmé par les catalogues consultés au 2 octobre 2026. Le déploiement initial est encadré ; il faut vérifier les droits du compte concerné.
Non. Le token est une unité de traitement variable. Il faut aussi distinguer entrée, sortie et réflexion, et consulter les limites du service réellement accessible.
Un modèle n’est pas à lui seul un agent persistant. Cette fonction demanderait une orchestration, un environnement, des outils et des conditions d’exécution documentés.
Non. Les candidatures sont examinées et l’accès est réservé aux partenaires approuvés, avec des conditions de sécurité et d’usage.
Les évaluations ne permettent pas cette conclusion. Une proposition doit être confrontée aux contraintes réelles, aux preuves disponibles et aux responsabilités de l’équipe.
Non. Les résultats proviennent des publications officielles Google. Cet article distingue ces mesures de notre analyse et de nos scénarios pédagogiques.
Conclusion
Argon rend intéressante une question plus large que le classement des modèles : comment poursuivre un travail complexe tout en conservant des preuves, un périmètre et un contrôle ? Les annonces de capacités doivent être lues avec leurs conditions d’accès et d’évaluation.
Pour webcreaplus, la prochaine étape n’est pas de promettre une autonomie totale. C’est de préparer des tâches représentatives, des critères de réussite et des limites claires, puis de vérifier la disponibilité effective avant tout pilote. Un modèle plus capable n’est utile que dans un système que l’on sait comprendre et maîtriser.