
Qu’est-ce qu’un agent IA, au-delà du chatbot ?
Dans cet article, un agent désigne un système qui utilise un modèle pour choisir et enchaîner des opérations vers un objectif, dans un périmètre donné.
Le chatbot produit généralement une réponse à votre message. Un assistant ajoute des fonctions utiles autour de cette conversation. Un agent peut sélectionner un outil, examiner son résultat, puis décider de la suite. Ces mots ne constituent pas une classification universelle : notre grille sert à comprendre les responsabilités confiées, plutôt qu’à départager les appellations commerciales.
La documentation de l’Agents API décrit justement un harness, c’est-à-dire une enveloppe d’exécution autour du modèle. Elle gère notamment des sessions durables, des outils et la reprise. Le modèle propose des actions ; le logiciel qui l’entoure les organise et les exécute. Confondre le modèle avec l’ensemble de l’agent fait oublier une grande partie du système.
L’autonomie n’est donc pas une indépendance absolue. Elle indique une marge de décision : choisir comment préparer une synthèse, par exemple, sans obtenir le droit de l’envoyer à des clients. Plus cette marge est explicite, plus il devient possible de juger le résultat. Une consigne vague comme « occupe-toi du marketing » laisse trop de décisions sans propriétaire.
Autonome, persistant, multi-agent : quatre notions à séparer
La persistance concerne la continuité du travail ; l’autonomie concerne les décisions ; l’asynchronisme concerne l’attente ; le multi-agent concerne la répartition.
Une tâche longue peut s’exécuter sans bloquer votre écran sans disposer d’une mémoire entre conversations. Inversement, un système peut conserver vos préférences tout en attendant une nouvelle demande. Un agent persistant associe une continuité d’état à la possibilité de reprendre une responsabilité ; il n’a pas nécessairement besoin de calculer à chaque seconde.
Le mode background de Responses illustre le premier cas : une réponse est demandée de façon asynchrone, suivie puis éventuellement annulée. Ce mécanisme n’équivaut pas, à lui seul, à un collaborateur permanent. Dots et les sessions de l’Agents API documentent d’autres formes de continuité, dans des produits et des environnements différents.
| Notion | Question utile | Ce qu’elle ne garantit pas |
|---|---|---|
| Autonomie | Peut-il choisir les prochaines étapes ? | Des droits illimités ou un résultat exact |
| Persistance | Peut-il reprendre avec un état utile ? | Une mémoire exhaustive ou une activité permanente |
| Asynchronisme | Peut-on quitter l’attente ? | Une responsabilité suivie entre conversations |
| Multi-agent | Peut-il répartir des sous-tâches ? | Un gain de temps ou de qualité systématique |
Comment un agent travaille : une boucle, pas une réponse magique
Un objectif devient une succession d’observations, de décisions et d’actions dont le résultat doit être vérifié.
Une lecture pédagogique de cette boucle est : objectif, plan, outil, action, observation, correction, validation. Le plan peut évoluer après une erreur ou une information nouvelle. Ce n’est pas une recette imposée à tous les produits, mais un moyen de repérer où une délégation peut déraper et où placer un contrôle.
Les outils donnent une portée pratique au raisonnement : consulter des documents, interroger une application, écrire un fichier ou utiliser un navigateur. Ils ne sont pas interchangeables. Une API impose un contrat de données ; un navigateur expose une interface et son contenu, parfois ambigu. Dans les deux cas, le résultat renvoyé doit être traité comme une observation, pas comme une instruction supérieure.
L’environnement d’exécution apporte ce que le texte d’un prompt ne peut pas garantir seul : accès techniques, isolation, identité des processus, traces et mécanismes d’arrêt. Une bonne délégation précise aussi la sortie attendue : un brouillon daté avec ses sources est contrôlable ; « améliore le dossier » l’est beaucoup moins.
La mémoire utile ne doit pas devenir une boîte noire
Conserver du contexte aide à reprendre un travail, mais oblige à savoir ce qui a été retenu, d’où cela vient et quand cela cesse d’être pertinent.
OpenAI distingue, pour Dots, la mémoire ChatGPT pertinente et des notes propres au dot. Ces notes peuvent suivre le travail entre conversations et canaux ; elles ne constituent pas une transcription complète. Changer les réglages de mémoire ChatGPT ne modifie pas nécessairement les notes déjà conservées par le dot.
La différence est importante pour une entreprise. Un ancien tarif, un interlocuteur remplacé ou une décision provisoire peut devenir un mauvais point de départ. Notre recommandation est de distinguer informations de référence, décisions validées et observations temporaires. Chaque élément sensible devrait conserver une provenance et une possibilité de révision.
La persistance change aussi la définition de l’arrêt. Mettre une activité en pause, arrêter un travail délégué et annuler une récurrence ne sont pas forcément la même opération. Les contrôles Dots les distinguent. Avant de confier une responsabilité continue, vérifiez donc le chemin d’arrêt complet plutôt que le seul bouton visible dans la conversation.
Dots : ce qu’OpenAI propose réellement au 2 octobre 2026
Dots est une expérience d’agent continu en déploiement progressif, pas une fonction instantanément accessible à tous les comptes ChatGPT.
Les notes DevDay du 29 septembre présentent Dots comme un agent pouvant suivre des responsabilités entre conversations. La documentation le décrit avec GPT-6 Astra, un ordinateur cloud et des applications connectées. Le travail cloud peut continuer lorsque vos appareils personnels sont éteints ; cela ne vaut pas pour une tâche qui dépend d’un ordinateur local hors ligne.
La page produit précise les conditions : l’accès à Dots via les offres Pro individuelles concernées est réservé aux adultes hors Espace économique européen, Royaume-Uni et Suisse. En France, il ne faut donc pas promettre cet accès à Dots. Business Premium et Enterprise ont un déploiement mondial conditionnel ; Enterprise demande une activation administrative. Une offre admissible ne garantit pas l’apparition immédiate du produit.
Pour démarrer une responsabilité, les guides demandent de préciser sources, résultat et décisions humaines. Connecter un canal de messagerie ne crée pas automatiquement une veille ni un accès à toute une boîte de réception. Ce cadrage reste la partie la moins spectaculaire, mais la plus utile pour éviter qu’une disponibilité commerciale soit prise pour une organisation déjà opérationnelle.
Computer use : agir dans un navigateur n’est pas disposer de tous les droits
Le computer use permet à un agent d’utiliser une interface ; les connexions et les autorisations demeurent des frontières distinctes.
Le changelog OpenAI du 29 septembre ajoute le computer use à l’Agents API, dans un navigateur hébergé. L’API elle-même était déjà en bêta publique depuis le 10 septembre. Le guide impose une approbation pour chaque nouvelle origine web, même publique, et prévoit un parcours de connexion géré par l’application.
Cette approbation d’accès n’assure pas une confirmation avant chaque achat ou suppression. La documentation avertit qu’une fonction de confirmation dépend du choix du modèle de l’appeler. Pour une frontière technique, il faut restreindre les ressources accessibles ou employer un environnement contrôlé. Fermer le flux de réponse n’arrête pas non plus le travail : il faut annuler le tour.
En pratique, nous conseillons de commencer avec des ressources qui ne permettent pas d’action irréversible. Un agent peut préparer une opération, expliquer les changements envisagés puis transmettre une demande à un circuit d’approbation extérieur. La personne doit voir ce qui sera changé, sur quel compte et avec quelle conséquence, pas seulement un message « continuer ? ».
Sous-agents : répartir le travail sans multiplier les erreurs
Un sous-agent reçoit une tâche bornée ; un agent principal doit ensuite rapprocher les résultats et gérer les dépendances.
La bêta multi-agent de Responses documente des sous-agents parallèles avec leur propre contexte, puis une synthèse par le principal. Au 2 octobre, elle est annoncée pour GPT-6.1 Sol et les modèles GPT-5.6. L’orchestration hébergée ne transforme pas les outils applicatifs en services automatiquement exécutés par OpenAI : l’application garde cette responsabilité.
Cette organisation convient mieux à des recherches indépendantes qu’à plusieurs intervenants modifiant le même fichier. Elle ajoute aussi du contexte, des tokens et des arbitrages. Le principal peut recevoir deux conclusions incompatibles ou oublier une réserve. La qualité dépend alors du contrat de chaque sous-tâche et de la vérification finale, pas du nombre d’agents lancés.
Pourquoi le coût d’un agent dépasse celui d’une conversation
Le budget dépend du parcours complet : modèle, contexte, outils, infrastructure, reprises et supervision.
Le 29 septembre 2026, OpenAI a lancé GPT-6.1 Sol. Les tarifs Standard documentés, pour les prompts jusqu’à 272 000 tokens d’entrée, sont de 2 dollars par million de tokens d’entrée et 10 dollars par million de tokens de sortie. Ces chiffres décrivent des tokens dans un périmètre précis, pas le prix d’un agent complet ni un tarif valable pour tous les modes.
Les guides de l’Agents API ajoutent les outils et conteneurs hébergés applicables à la facturation du modèle. Notre analyse est qu’un modèle capable à coût inférieur rend plus de cycles de travail envisageables, mais ne garantit pas une meilleure économie finale. Un modèle moins cher qui recommence souvent peut annuler l’avantage attendu.
Un budget exploitable fixe un plafond de coût, une durée, un nombre d’essais et un comportement en cas de blocage. Mesurez le coût d’un résultat vérifié, pas seulement d’une requête réussie. La comparaison doit inclure le temps humain de contrôle et les opérations qu’il faut finalement refaire.
Avant un premier pilote
- Définir une sortie vérifiable et un critère d’acceptation.
- Limiter les sources, les outils et les tentatives.
- Prévoir une alerte avant le plafond budgétaire.
- Interdire l’escalade automatique des permissions pour contourner un blocage.
- Comparer le résultat à une procédure humaine de référence.
Les permissions doivent exister ailleurs que dans le prompt
Une instruction peut orienter une décision ; des contrôles techniques imposés hors de l’agent limitent les opérations effectivement autorisées.
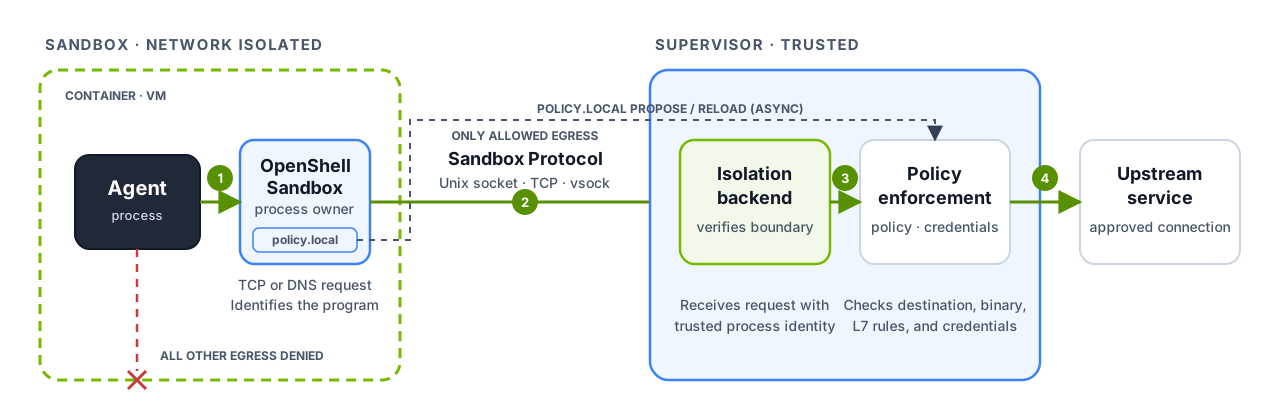
Le billet NVIDIA du 21 août distingue cette guidance comportementale de l’autorité infrastructurelle. Il documente les risques de permissions excessives, de données non fiables prises pour des instructions, d’effets externes incontrôlés et de cascades entre agents. Les limites doivent donc s’appliquer au moment où une action tente de produire un effet.
Une injection de prompt peut se trouver dans une page ou un document consulté. La frontière technique ne promet pas que l’agent ne sera jamais influencé ; elle vise à limiter les conséquences qu’il peut effectivement provoquer. C’est notre lecture de cette séparation : la prudence du modèle et l’isolation de l’environnement répondent à deux problèmes complémentaires.
Le principe pratique consiste à donner le minimum nécessaire, pour une durée et une tâche explicites. Lire n’autorise pas écrire ; rédiger n’autorise pas envoyer. Une permission générale sur un compte de production peut transformer une erreur locale en incident réel. La validation humaine est utile seulement si elle accompagne des limites techniques et des traces compréhensibles.
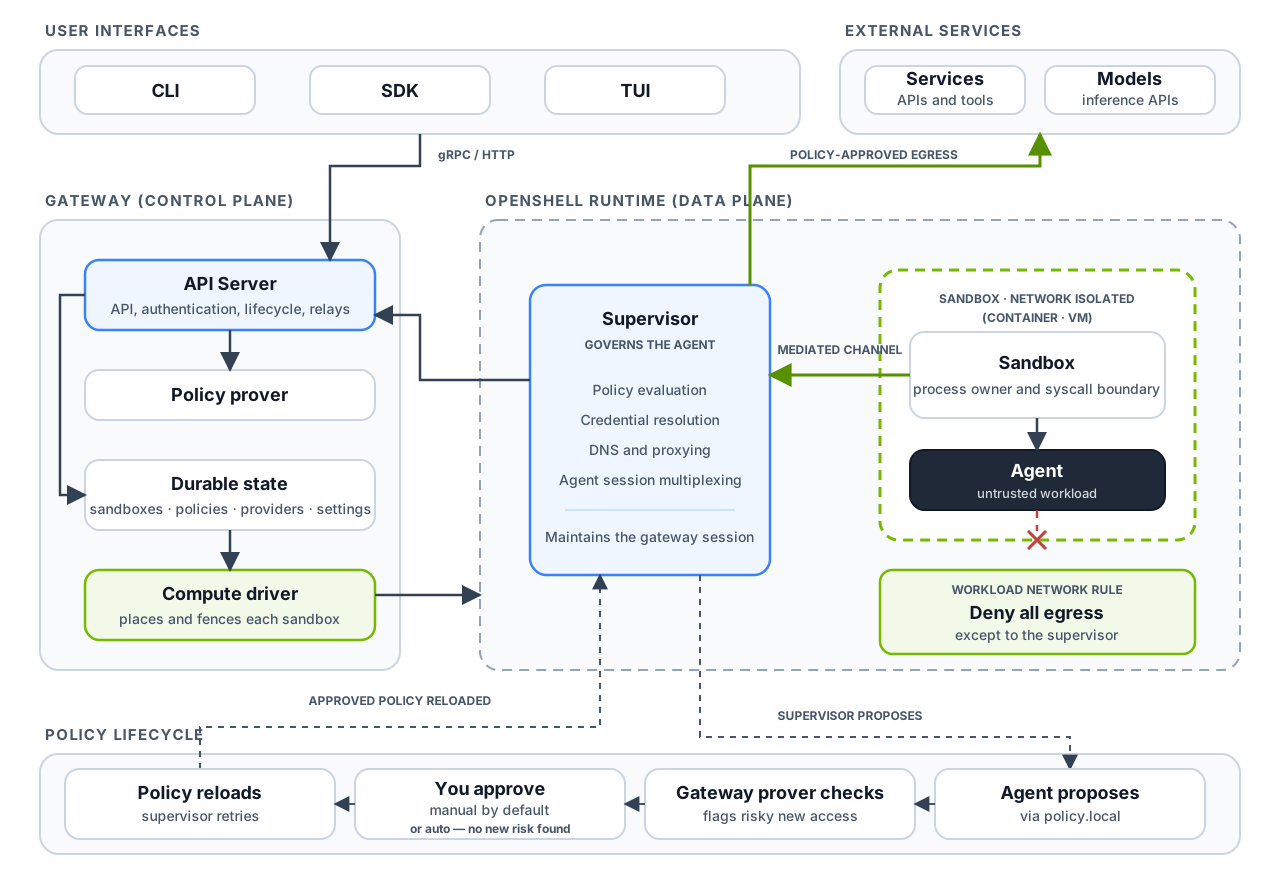
OpenShell : un runtime pour limiter ce que l’agent peut exécuter
NVIDIA sépare le travail de l’agent des mécanismes qui contrôlent ses fichiers, processus et communications.
Le billet technique du 28 septembre décrit trois rôles : Gateway pour le cycle de vie et les politiques, Supervisor extérieur au workload pour examiner les requêtes, Sandbox avec contrôles noyau sur fichiers et processus. Les contrôles peuvent accompagner du code généré ou des processus enfants ; les véritables clés sont substituées hors de l’agent vers les destinations autorisées.
OpenShell est disponible comme runtime open source. La release v0.1.2 du 28 septembre est la plus récente identifiée lors du contrôle, alors que le billet présente v0.1.0. La FAQ NVIDIA précise que BlueField-4 n’est pas requis pour utiliser OpenShell sur les infrastructures prises en charge. Il faut distinguer le runtime logiciel du matériel du design de référence.
Les mécanismes de politique ont eux-mêmes des limites. La documentation versionnée indique que Policy Advisor est désactivé par défaut et soumis par défaut à une revue manuelle ; une auto-approbation optionnelle existe. Le Policy Prover vérifie des propriétés représentées dans son modèle, pas l’adéquation d’une politique à toute tâche ni son application réelle par chaque sandbox. Un résultat positif n’est donc pas un certificat universel de sûreté.
Sentry : surveiller depuis l’extérieur, sans confondre annonce et produit
Sentry est un watchdog logiciel optionnel, exécuté sur BlueField-4, dans le design de référence Open Agent Safety Platform présenté par NVIDIA.
L’annonce du 28 septembre associe OpenShell à Sentry, décrit sur BlueField-4 avec DOCA. Le blog technique présente une surveillance indépendante du travail de l’agent et un contrôle hors bande dans l’architecture Vera Rubin POD. La disponibilité annoncée d’OpenShell ne suffit pas à établir celle d’un package Sentry autonome téléchargeable.
NVIDIA relie ce contrôle à la dérive : les actions peuvent s’écarter de la tâche ou des contraintes, notamment après des échecs répétés ou des instructions ambiguës. Notre analyse est que plus une responsabilité dure, plus la supervision doit examiner le parcours et les effets, pas seulement le message final. Cette logique ne rend pas toute dérive détectable ni tout objectif correctement formulé.
Ce qui est raisonnable aujourd’hui, et ce qui reste à résoudre
Un usage réaliste commence par un travail réversible et mesurable ; une autonomie ouverte sur des systèmes sensibles demande beaucoup plus qu’une bonne démonstration.
Préparer une synthèse sourcée, examiner un dépôt isolé ou comparer des informations autorisées sont des pistes de pilote, pas des promesses de réussite. Pour une TPE ou une PME, une responsabilité petite mais suivie vaut souvent mieux qu’un périmètre transversal impossible à contrôler. Une phase d’essai doit exposer les erreurs autant que les résultats utiles.
Les cartes de sécurité GPT-6 Astra et GPT-6.1 Sol publient des évaluations de comportements et des limites. Les scénarios Dots utilisant des budgets jusqu’à un an emploient du temps simulé : ils ne prouvent pas un agent réel autonome pendant une année. Les mécanismes d’auto-review et de surveillance ne constituent pas une garantie d’obéissance parfaite.
Les données sont une autre contrainte. Le guide actuel de l’Agents API indique une résidence aux États-Unis et l’absence de Zero Data Retention. Il ne faut pas lui attribuer les options européennes d’un modèle utilisé dans une autre API. Choisir une solution exige de vérifier le produit précis, ses flux et ses modalités de conservation.
L’interface peut évoluer vers un tableau de responsabilités, de preuves et de décisions en attente plutôt qu’une liste de conversations. C’est une perspective webcreaplus, pas une disparition annoncée des applications. Les interfaces restent nécessaires pour inspecter, corriger, autoriser et arrêter. L’agent utile n’est pas celui qui cache le travail : c’est celui qui le rend contrôlable.
Questions fréquentes
Un travail exécuté dans le cloud peut continuer, si le produit et ses permissions le permettent. Un travail dépendant d’un ordinateur local hors ligne ne le peut pas. Les guides Dots distinguent ces deux environnements.
La mémoire conserve certaines informations. La persistance permet de reprendre une responsabilité avec un état utile. Aucune des deux n’implique automatiquement une mémoire exhaustive, une durée illimitée ou une action permanente.
Au 2 octobre 2026, l’accès à Dots via Pro individuel exclut l’EEE, donc la France. Business Premium et Enterprise ont un déploiement mondial sous conditions ; Enterprise exige une activation administrative. L’éligibilité ne garantit pas l’accès immédiat.
Non. Des tâches indépendantes peuvent profiter du parallélisme, mais les contextes, les coûts et la coordination augmentent. Un travail séquentiel ou plusieurs agents écrivant au même endroit peuvent rendre cette organisation moins pertinente.
Non. Il limite des opérations selon une politique donnée, qui peut elle-même être mal choisie. Les décisions du modèle, les données consultées, les accès et les contrôles extérieurs restent à examiner.
Quel travail est autorisé, quels outils et données sont accessibles, où l’état est conservé, quelles actions exigent une validation, comment les dépenses sont limitées et comment arrêter aussi les tâches déléguées ou récurrentes.
Conclusion
La rupture n’est plus seulement une IA qui répond mieux, mais une IA capable de poursuivre un objectif dans le temps et d’agir dans un environnement contrôlé. Les annonces de septembre 2026 rendent cette trajectoire tangible, avec des produits dont la disponibilité et les garanties restent différentes.
Le bon point de départ n’est pas « combien d’autonomie peut-on donner ? », mais « quelle responsabilité pouvons-nous délimiter, observer et reprendre ? ». Mémoire, outils, budget, permissions et supervision doivent former un contrat lisible. C’est ce contrat, davantage que le vocabulaire commercial, qui rend une délégation utile.